# ARTEX 한국어판
**LLM 멀티 에이전트가 자율적으로 침투 테스트를 수행하는 시스템** (Go 백엔드 + Next.js 프런트엔드)
한국어 · [中文](README.zh.md) · [English](README.en.md)
[](LICENSE)
---
> ## 🚨 보안·오남용 경고: 반드시 먼저 읽어 주세요
>
> **이 저장소는 권한을 받은 환경에서, 방어와 탐지 역량을 기르기 위한 목적으로만 쓰도록 공개합니다.**
>
> ARTEX 는 사람이 거의 개입하지 않아도 정찰부터 침투, 자료 반출까지 공격 과정을 스스로 수행할 만큼 강력한 자율 공격 도구입니다. 그만큼 오남용이 일으키는 피해도 큽니다. 2026년 10월 국내 여러 언론은 원본 ARTEX 가 국내 금융기관을 상대로 한 개인정보 유출 공격에 사용된 정황이 조사 당국에 포착됐다고 보도했으며, 관련 수사가 진행 중입니다. 이 한국어판을 공개하는 목적은 공격을 돕는 데 있지 않습니다. 방어하는 쪽이 이런 자율 AI 공격의 작동 원리를 이해하고, 탐지하고 차단하는 역량을 갖추도록 돕는 데 목적이 있습니다.
>
> - **허가 없는 사용은 그 자체로 범죄가 됩니다.** 자신이 소유하거나 서면으로 명시적 허가를 받은 대상이 아니라면, 어떤 시스템에도 스캐닝·탐지·익스플로잇을 실행하지 마십시오. 대한민국에서 권한 없이 정보통신망에 침입하는 행위는 정보통신망법 위반이고, 개인정보가 결부되면 개인정보보호법도 함께 적용됩니다.
> - **실제 서비스나 타인의 자산을 대상으로 삼지 마십시오.** 학습과 연구, 그리고 본인이 소유한 로컬 격리 환경(OWASP Juice Shop·DVWA 처럼 의도적으로 취약하게 만든 환경)에서만 검증하십시오.
> - **방어하는 관점으로 읽으십시오.** 이 저장소는 자율 AI 공격의 탐지 시그니처와 하드닝 체크리스트 같은 방어·탐지 자료를 함께 정리해 나갑니다. → **[자율 AI 공격 방어·탐지 가이드](docs/defense-ko.md)**
>
> 이 경고와 아래 [사용 제한·면책](#라이선스와-면책)에 동의하지 않는다면, 이 저장소를 내려받거나 사용하지 마십시오.
---
> **이 저장소는 중국산 오픈소스 프로젝트 [Autumn-27/ARTEX](https://github.com/Autumn-27/ARTEX)(AGPL-3.0)를 한국 사용자와 팀이 그대로 쓸 수 있도록 현지화한 판본입니다.** 에이전트의 판단 성능을 보존하기 위해 내부 추론 프롬프트는 원문을 유지하고, 사용자에게 보이는 산출물(탐지 결과·요약·리포트·대화 응답)만 한국어로 강제합니다. 아래 "왜 한국어판인가"에서 방침을 설명합니다.
ARTEX 는 LLM 이 조종하는 여러 에이전트가 **스스로 목표를 쪼개고, 실제 도구를 실행하고, 발견한 자산과 취약점을 그래프에 쌓아 가며** 침투 테스트 과정을 자율적으로 끌고 가는 시스템입니다. Go 단일 바이너리 하나에 Next.js 프런트엔드가 내장되어 있고, 데이터는 PostgreSQL 에 저장됩니다.
---
## ⚠️ 먼저 읽어 주세요 — 사용 범위와 국내법 고지
ARTEX 는 **자신이 소유하거나 서면으로 명시적 허가를 받은 대상에 대해서만** 사용할 수 있습니다. 허가 범위를 벗어난 스캐닝·탐지·익스플로잇은 그 자체로 불법이 될 수 있습니다.
- 대한민국에서 권한 없이 타인의 정보통신망에 침입하거나 장애를 일으키는 행위는 **「정보통신망 이용촉진 및 정보보호 등에 관한 법률」** 위반입니다.
- 침투 테스트 과정에서 수집·노출되는 개인정보는 **「개인정보 보호법」** 의 적용을 받습니다. 권한이 있더라도 개인정보 열람·보관·파기를 신중히 다뤄야 합니다.
- **학습·연구·로컬 격리 환경 검증** 목적으로 쓰십시오. 운영 중인 외부 시스템을 대상으로 삼기 전에는 반드시 서면 허가와 범위·시간창 합의를 확보해야 합니다.
자세한 라이선스·사용 제한·면책은 아래 [라이선스와 면책](#라이선스와-면책) 절에 있습니다. 이 도구를 사용하는 것만으로 사용자는 그 조건에 동의한 것으로 봅니다.
---
## 왜 한국어판인가
원본 ARTEX 는 프롬프트·UI·문서가 모두 중국어로 되어 있어, 국내 사용자가 결과를 읽고 팀과 공유하기가 번거로웠습니다. 이 한국어판은 다음을 목표로 합니다.
- **산출물의 한국어화**: 에이전트가 사람에게 내보내는 탐지 결과·사실 요약·최종 리포트·대화 응답을 한국어로 출력하도록 강제합니다. 명령·페이로드·코드·URL·로그 원문은 분석에 필요하므로 원본 그대로 둡니다.
- **성능 보존**: 에이전트의 판단을 좌우하는 내부 추론 프롬프트(행동 지침 본문)는 번역하지 않습니다. 원문으로 벤치마크된 동작을 유지하고, 출력 언어만 바꿔 번역에서 오는 품질 저하를 피합니다.
- **국내법 고지**: 정보통신망법·개인정보보호법 고지와 "권한 범위 안에서만 사용" 경고를 한국어로 분명히 제공합니다.
- **국내 스택 대응**: LLM 공급자를 프런티어 모델뿐 아니라 OpenAI 호환 엔드포인트(국산·오픈 모델)로 교체할 수 있습니다. 아래 [설정](#설정)을 참고하십시오.
> 현지화의 경계와 설계 방침은 저장소의 작업 문서에 더 자세히 적혀 있습니다. 상류(upstream) 저장소의 변경을 대조하기 쉽도록 원본 중국어 문서는 `README.zh.md` 로 보존합니다.
---
## 화면 미리 보기
아래 세 화면은 한국어화를 마친 실제 UI 입니다. 로컬 격리 샌드박스에서 뽑은 데모 데이터이고, 대상은 전부 가상의 `acme.com` 과 사설 대역입니다.
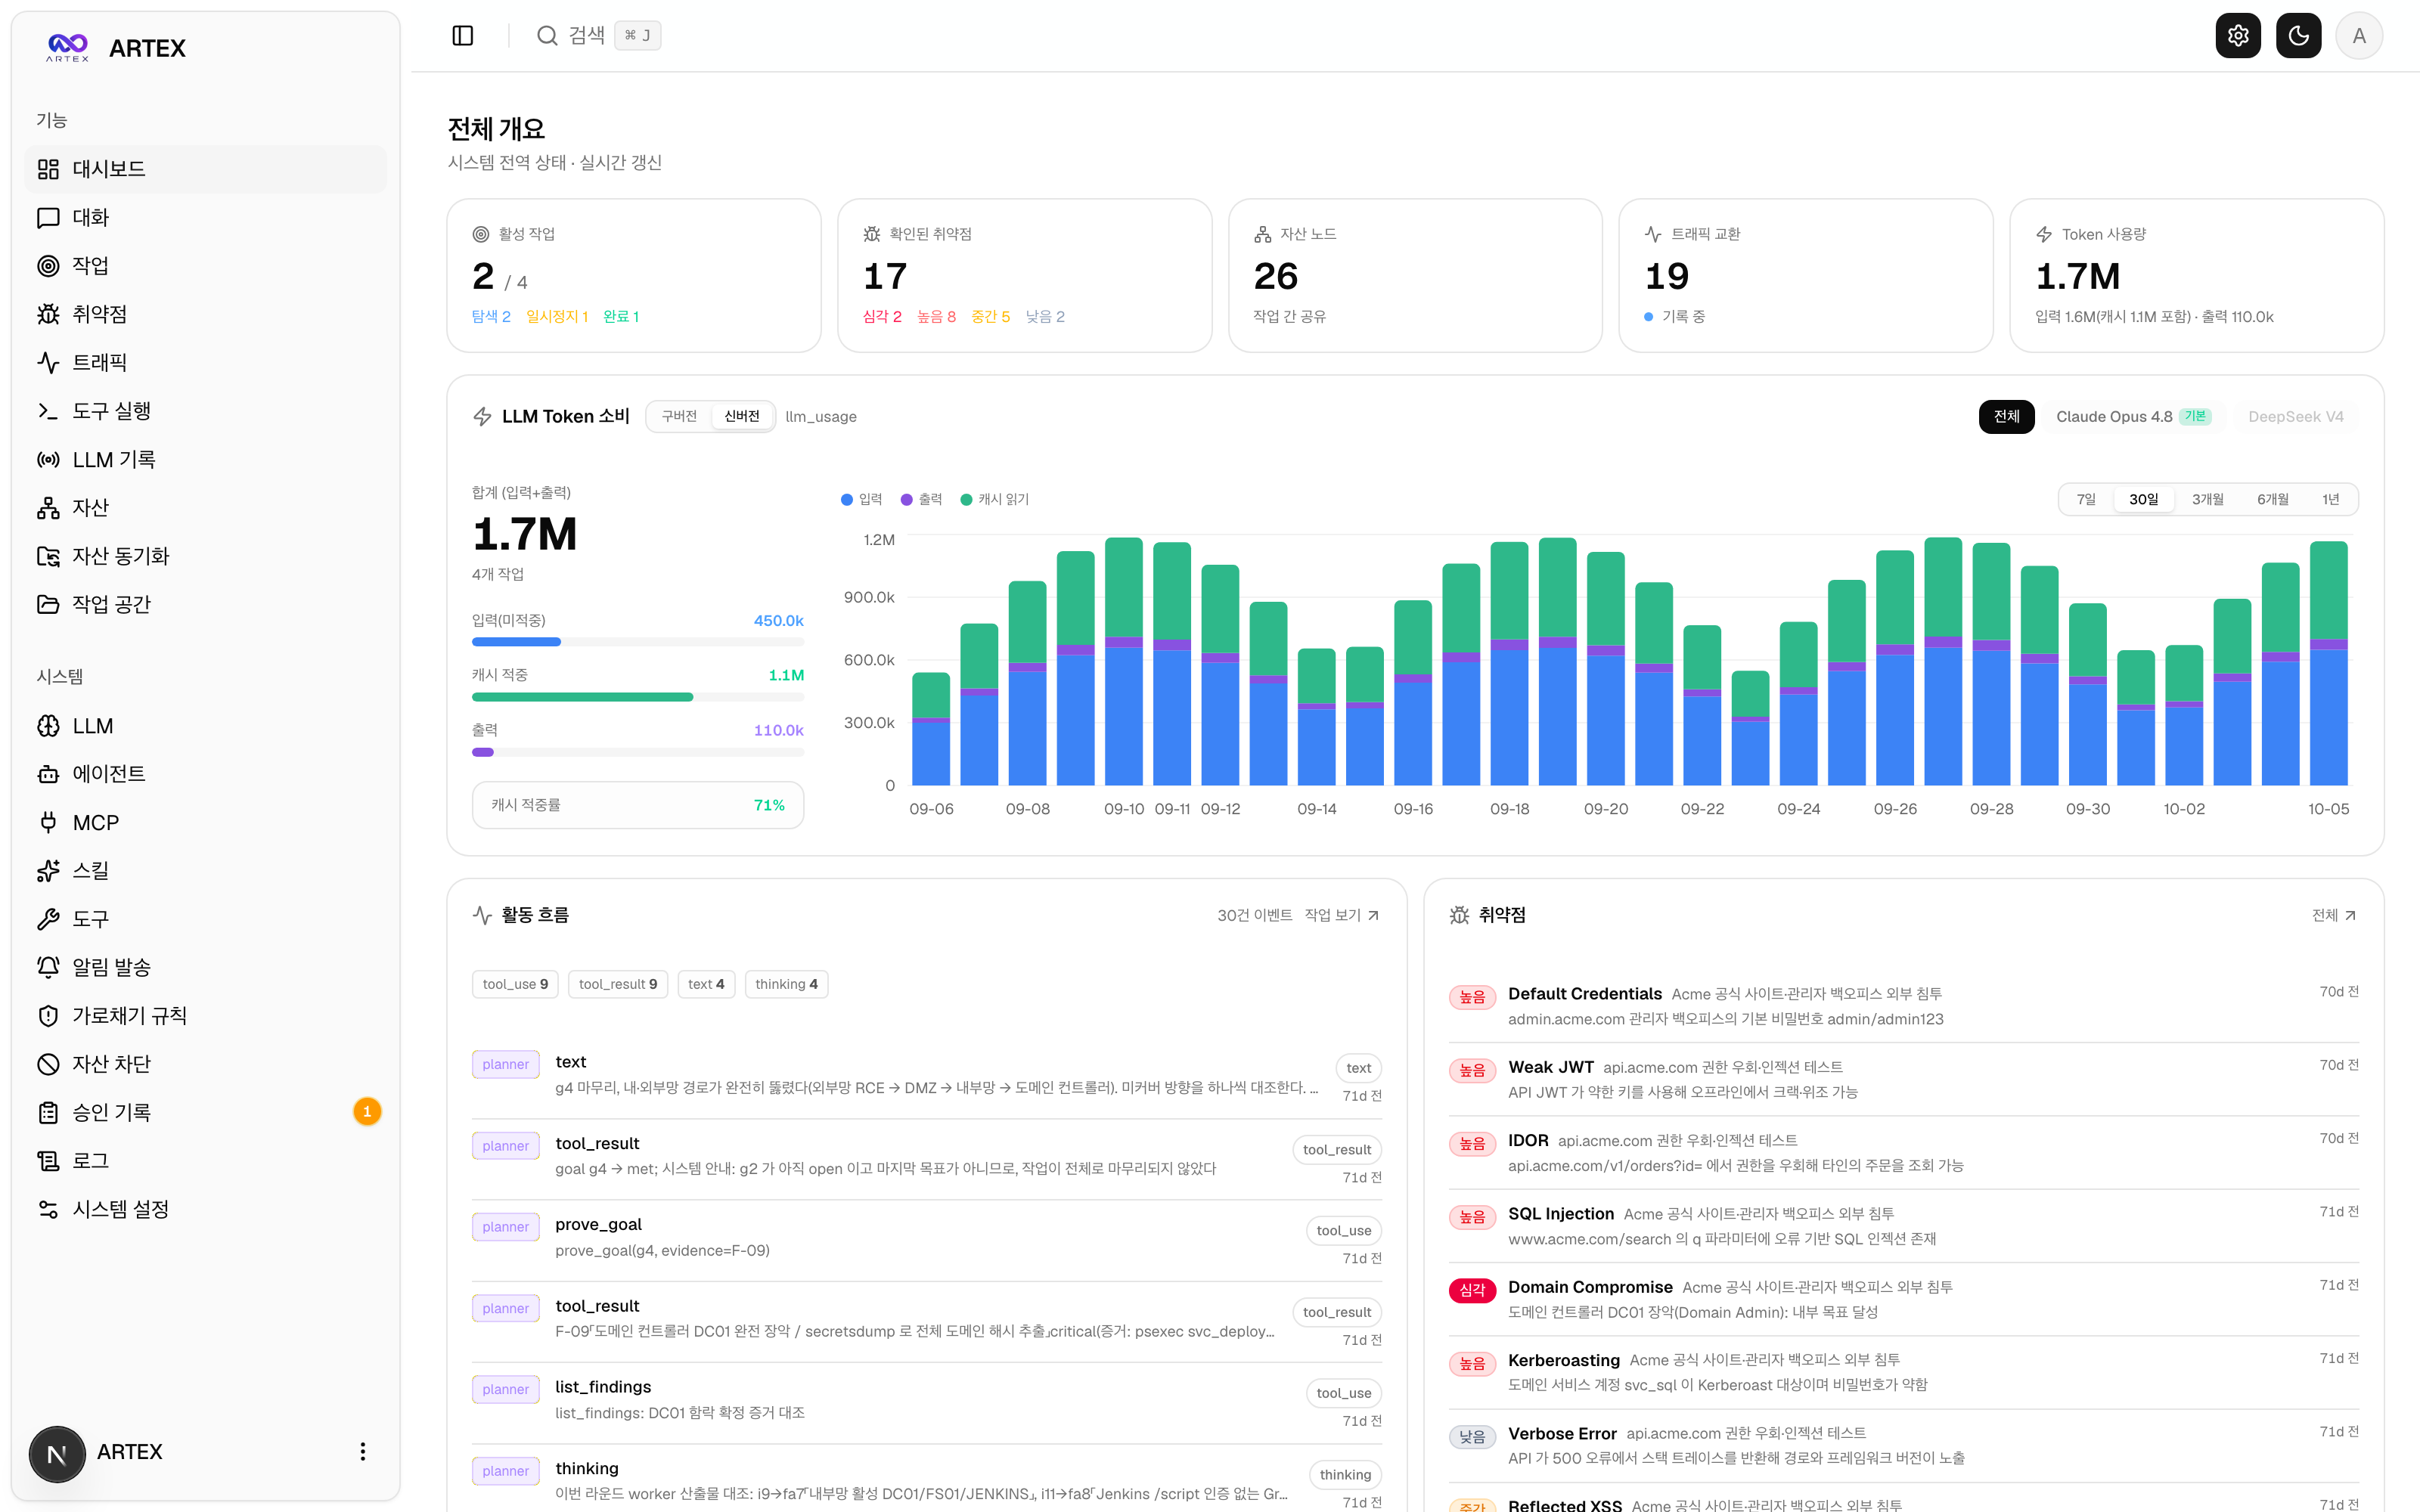
대시보드: 활성 작업·확인된 취약점·자산 노드·LLM 토큰 소비와 활동 흐름을 한 화면에서 봅니다.
이 대시보드 화면은 라벨을 현지화하기 전에 뽑은 데모 캡처라, 'LLM Token 소비' 카드의 데이터 원본 이름이 아직 코드 식별자 llm_usage 로 보입니다. 현재 빌드는 같은 자리를 신버전 「계량 원장」·구버전 「활동 통계」 로 표시합니다.
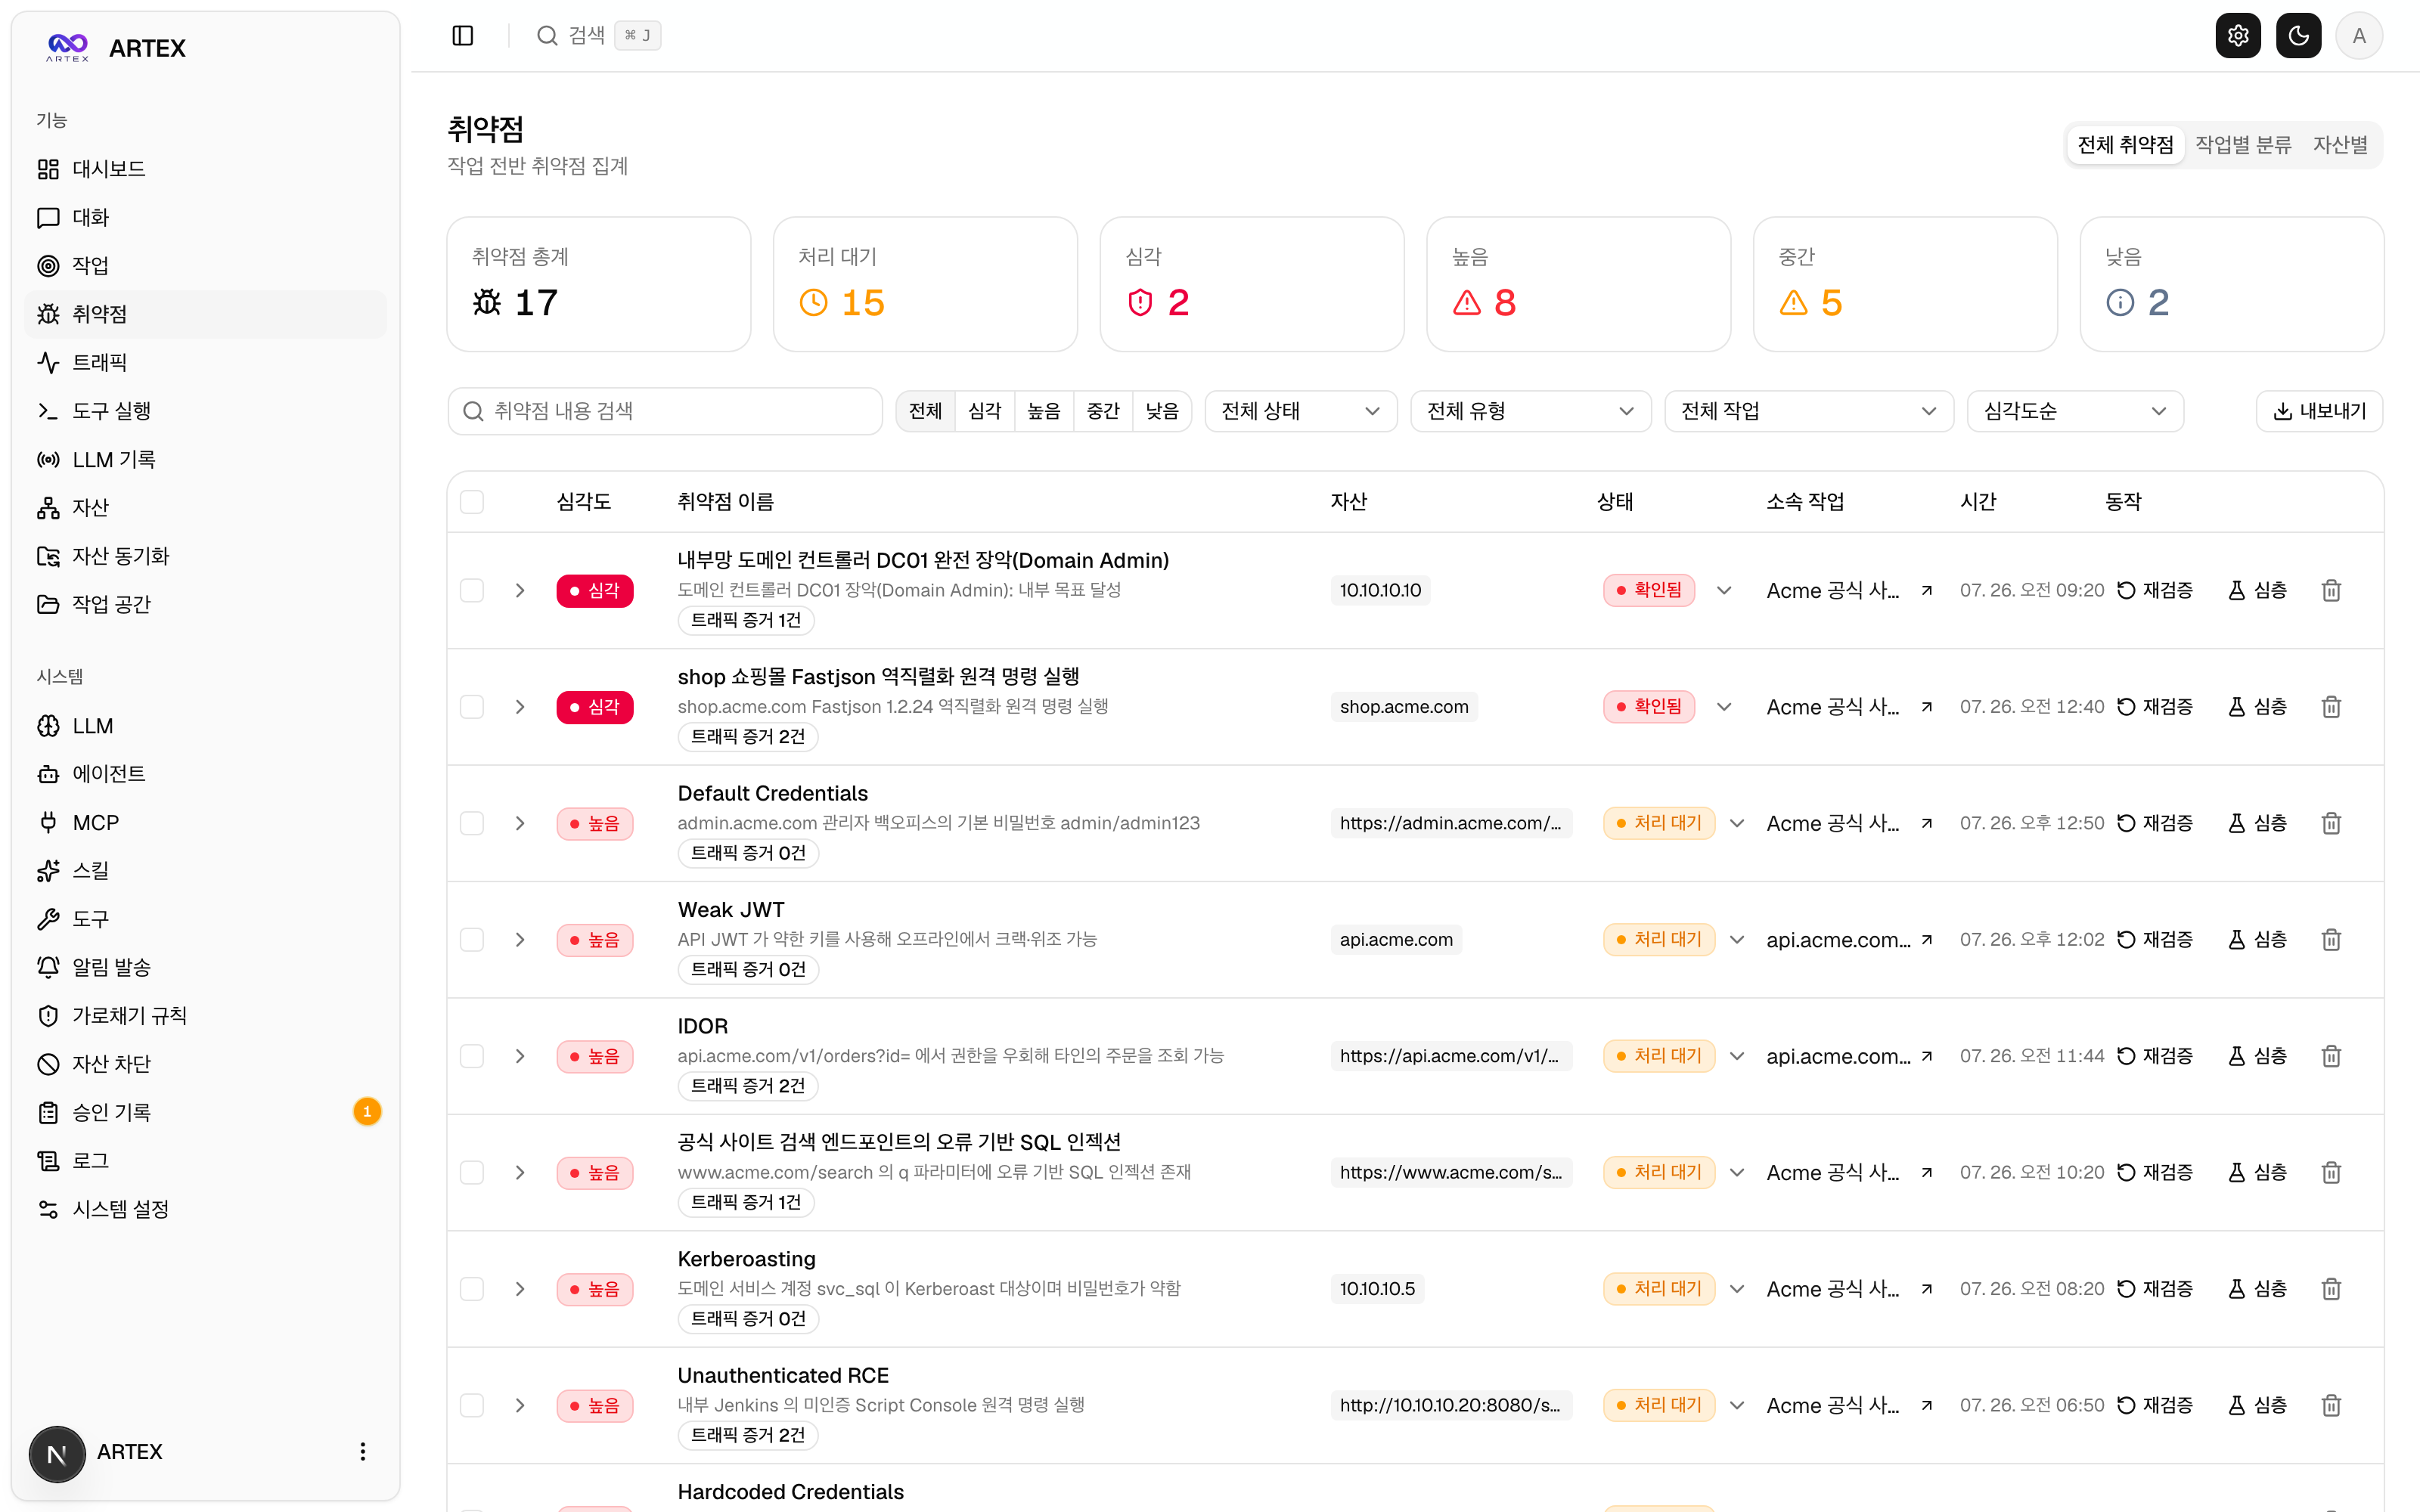
취약점: 심각도·상태·자산·소속 작업으로 탐지 결과를 집계하고 CSV 로 내보냅니다.
취약점 제목은 모델이 생성한 값이라, 대상 앱과 기술 용어를 따라 영어가 섞일 수 있습니다([모델 선택과 출력 언어](#모델-선택과-출력-언어) 참조). 제목 아래 설명과 화면 전체는 한국어로 나옵니다.
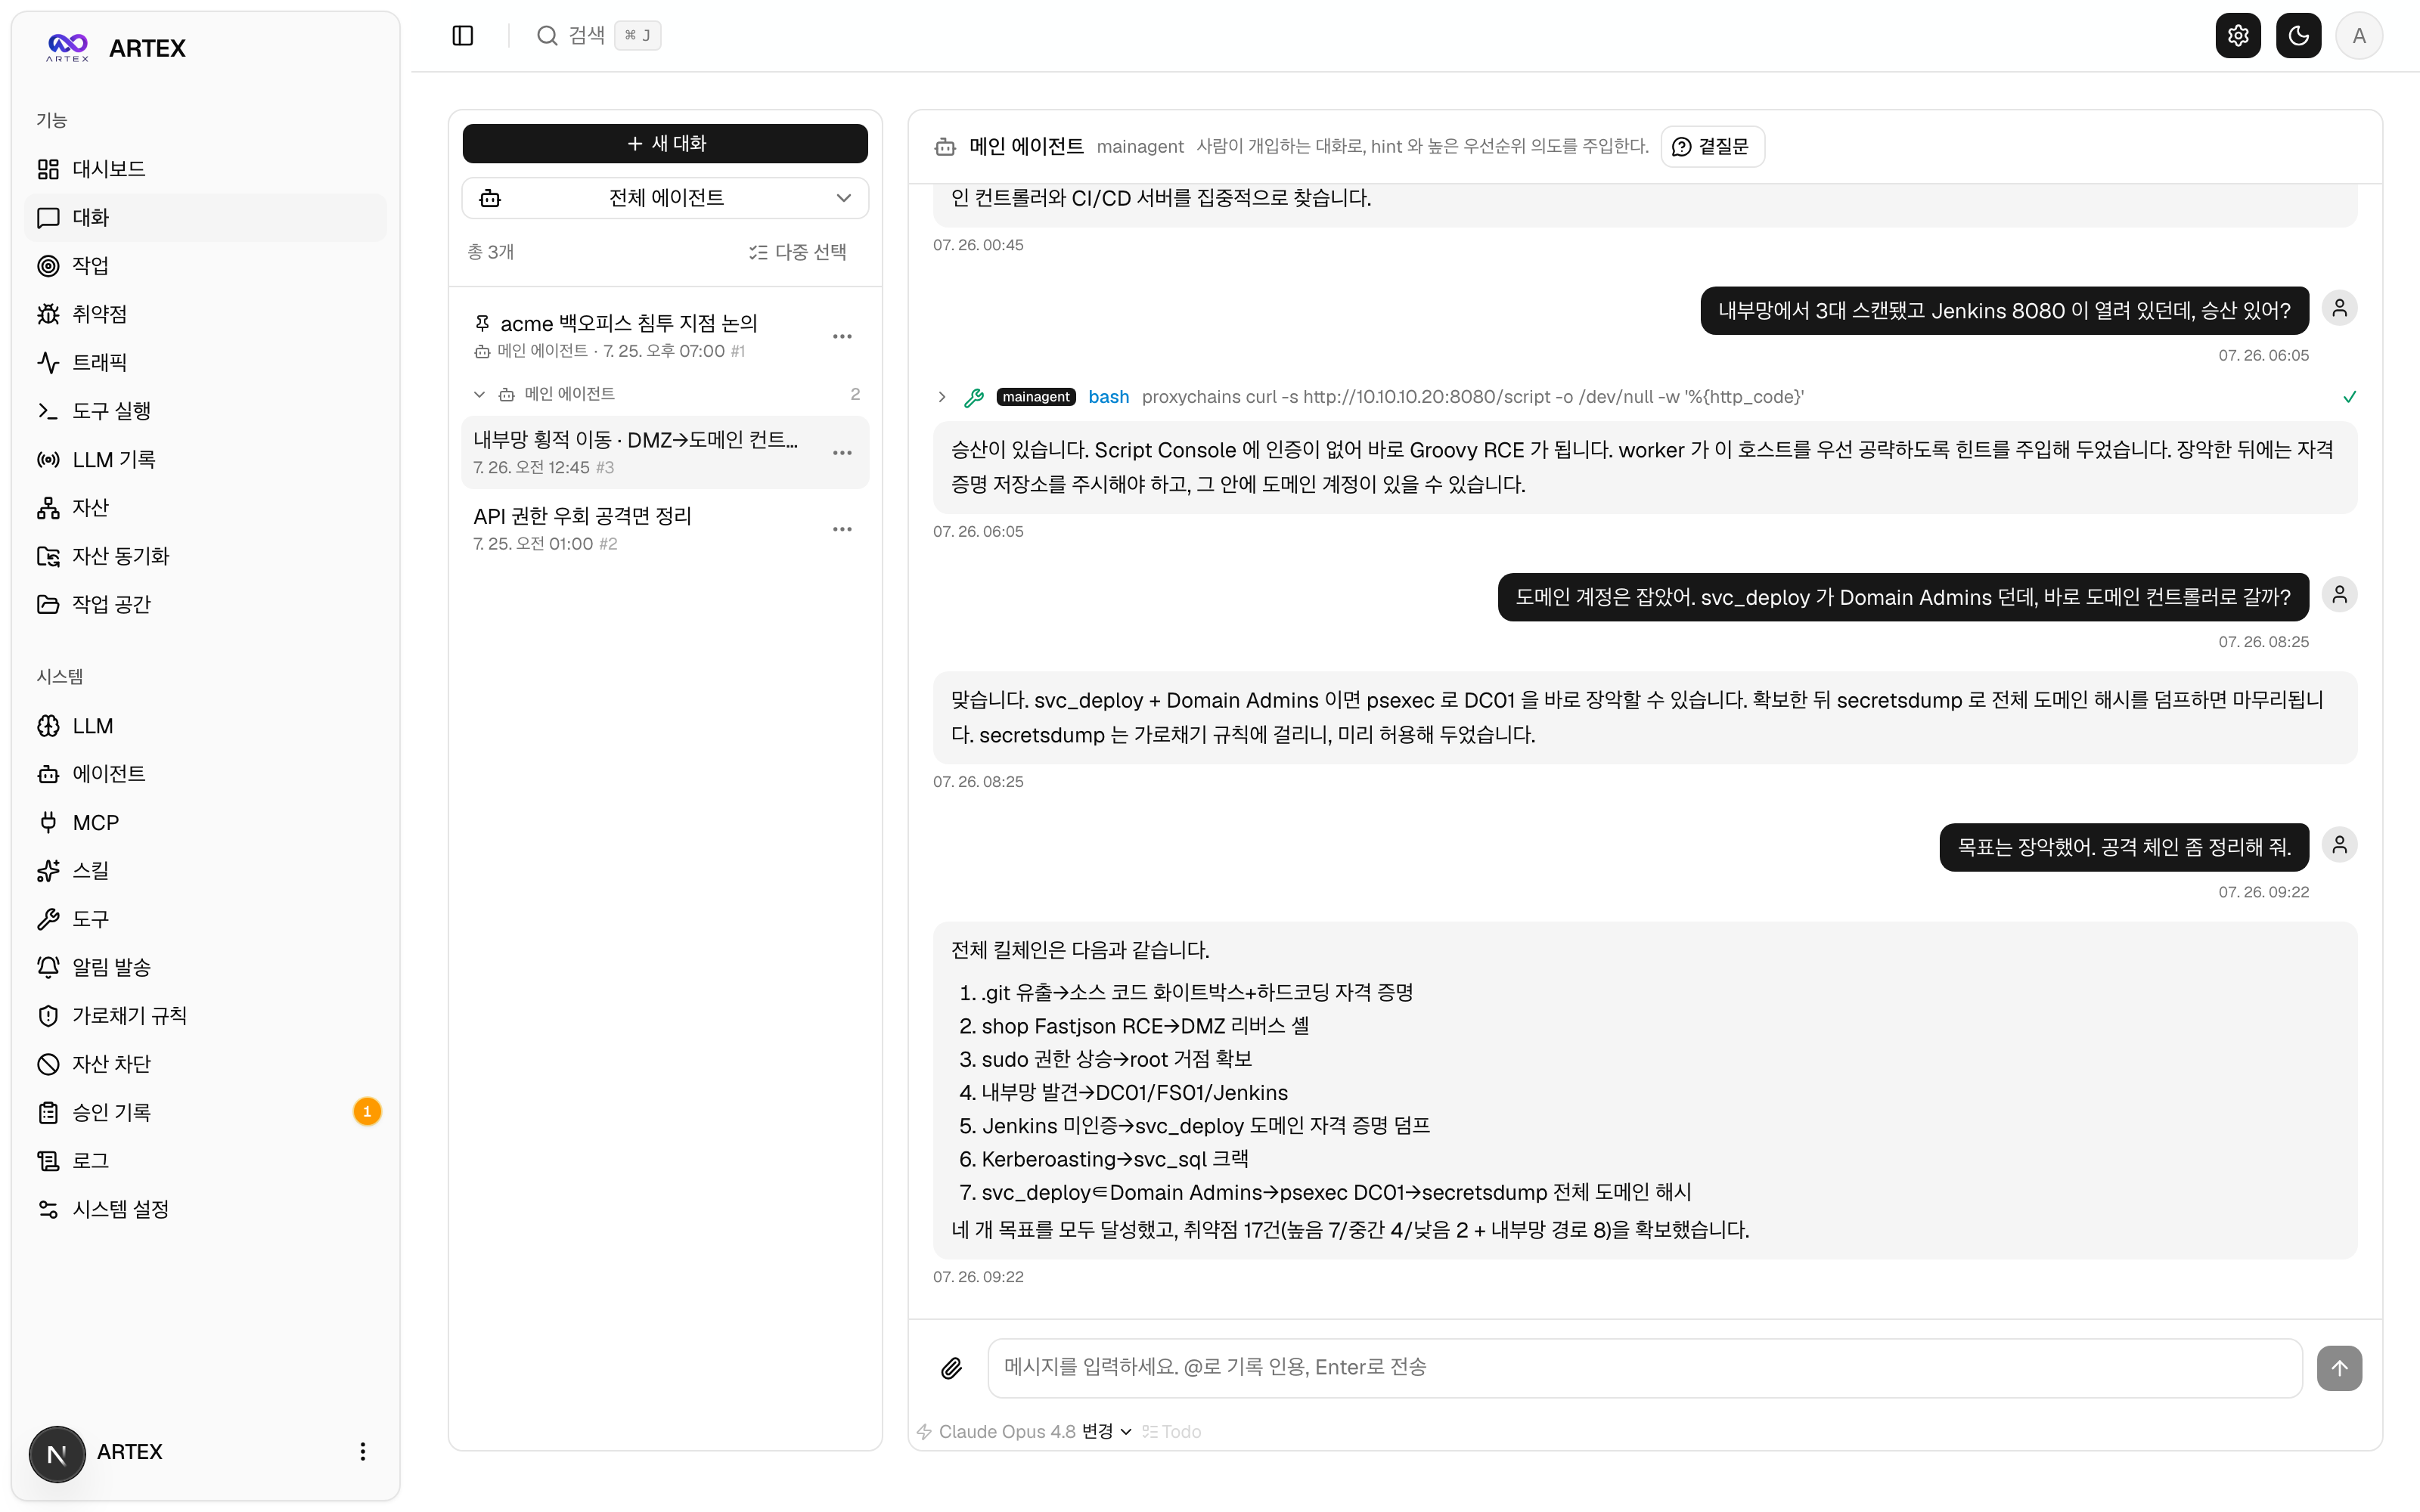
대화: 자율 실행 중에 사람이 끼어들어 힌트를 주고, 에이전트가 공격 체인을 한국어로 요약합니다.
원본(중국어 UI) 전체 화면은 [`README.zh.md`](README.zh.md#截图预览) 에서 볼 수 있습니다.
---
## 빠른 시작 (Docker Compose)
> **사전 요구:** Docker 와 Docker Compose. 데이터베이스는 **PostgreSQL** 이며 compose 가 함께 띄웁니다. 탐색에는 **LLM** 이 필요합니다(`ANTHROPIC_API_KEY` 또는 `OPENAI_API_KEY`, UI 에서도 설정 가능).
> **⚠️ 지금 이 compose 가 내려받는 이미지는 상류(원본) 중국어 빌드입니다.** `docker-compose.yml` 의 `artex` 서비스는 원작자가 Docker Hub 에 올린 `autumn27/artex` 이미지를 받습니다. 이 이미지는 **중국어 UI 와 중국어 출력**이라서, 이 저장소가 더한 한국어화(한국어 UI·한국어 리포트·`langDirective`)는 **아직 담겨 있지 않습니다**. 한국어판 화면과 출력을 확인하려면 지금은 아래 ["그 밖의 설치 방법"](#그-밖의-설치-방법)에 있는 **소스에서 단일 바이너리 컴파일** 경로로 직접 빌드하십시오. 한국어판 Docker 이미지의 배포는 준비 중입니다.
```bash
git clone https://gitea.mygoband.com/carrydela/artex.git
cd artex
cp .env.example .env # POSTGRES_PASSWORD 설정, ANTHROPIC_API_KEY 는 선택
docker compose up -d # artex 이미지 + postgres 를 함께 기동
# → http://localhost:8787 접속 (처음 들어가면 /setup 에서 관리자 비밀번호 설정)
```
위 상류 이미지에는 자주 쓰는 도구(ripgrep·curl·vim·npm·nmap 등)가 들어 있습니다. `./skills` 와 `./data` 는 바인드 마운트로 호스트에 남아 컨테이너를 다시 만들어도 보존됩니다.
### 그 밖의 설치 방법
원본 저장소는 설치 스크립트(`./install.sh`), 사전 컴파일 바이너리(Releases), 소스 단일 바이너리 컴파일 등 여러 방법을 제공합니다. 명령과 절차는 [`README.zh.md`](README.zh.md#安装)의 "安装"(설치) 절에 정리되어 있으며, 아래 핵심만 옮깁니다.
- **설치 스크립트:** `./install.sh` 를 실행하면 Docker 감지·설치 후 "① 전부 Docker" 또는 "② 로컬 컴파일 실행"을 고르게 합니다. 다만 기본값인 "① 전부 Docker" 는 위 빠른 시작과 같은 **상류 중국어 이미지**(`autumn27/artex`)를 받으므로, 한국어판 화면·출력을 보려면 "② 로컬 컴파일 실행"을 고르거나 아래 **소스에서 단일 바이너리 컴파일** 경로로 빌드하십시오. 스크립트도 "① 전부 Docker" 기동을 마치면 같은 안내를 출력합니다.
- **소스에서 단일 바이너리 컴파일:**
```bash
cd web && npm ci && npm run build:static && cd .. # 1) 프런트엔드 정적 빌드
rm -rf server/webui/dist && mkdir -p server/webui/dist && cp -a web/out/. server/webui/dist/ # 2) 내장 디렉터리로 동기화(재빌드 시 중첩 방지)
CGO_ENABLED=0 go build -tags embedui -o artex ./cmd/artex # 3) 프런트 내장 컴파일
./start.sh # → http://localhost:8787
```
> 1) 단계의 `npm ci` 는 빌드에 필요한 devDependencies(예: `@tailwindcss/postcss`)를 함께 설치합니다. 셸에 `NODE_ENV=production` 이 설정돼 있으면 `npm ci` 가 devDependencies 를 건너뛰어 빌드가 `Error: Cannot find module '@tailwindcss/postcss'` 로 실패하므로, 이때는 `npm ci --include=dev` 로 받으십시오.
> 실행은 `./artex` 를 직접 돌리지 말고 `start.sh`(Windows 는 `start.bat`)로 하십시오. 이 스크립트는 종료 코드에 따라 프로그램을 다시 띄우는 감시자이고, UI 의 "원클릭 업데이트"도 이 스크립트가 처리합니다.
---
## 설정
**데이터베이스**(`config.json`, 또는 환경 변수 `ARTEX_PG_DSN` 로 덮어쓰기):
```json
{
"database": {
"host": "127.0.0.1", "port": 5432,
"user": "artex", "password": "yourpass",
"dbname": "artex", "sslmode": "disable"
}
}
```
**LLM:** `export ANTHROPIC_API_KEY=sk-...`(또는 `OPENAI_API_KEY`), 혹은 UI 의 "LLM 설정" 페이지에서 입력합니다. 선택 환경 변수로 `ARTEX_LLM_PROVIDER` / `ARTEX_LLM_MODEL` / `ARTEX_LLM_BASE_URL` / `ARTEX_LLM_PROXY` 를 둘 수 있습니다. 국산·오픈 모델을 쓰려면 OpenAI 호환 `ARTEX_LLM_BASE_URL` 을 지정하십시오.
**동시성:** 작업마다 돌리는 worker 에이전트 수는 "시스템 설정"에서 조정합니다(기본값 3).
**자주 쓰는 인자:** `./start.sh -addr :8787 -proxy :8788` 에서 `-addr` 는 프런트엔드와 API 를 열고, `-proxy` 는 트래픽 기록 프록시 포트입니다.
### 모델 선택과 출력 언어
산출물의 한국어화는 하드 코딩된 상한이 아니라 **프롬프트 지시(`agent/prompt.go` 의 `langDirective()`)로 유도**합니다. 그래서 출력이 한국어로 유지되는 정도는 모델의 역량과 역할, 맥락에 따라 달라집니다.
- **역량 있는 프런티어 모델을 권장합니다.** 로컬 격리 샌드박스에서 프로덕션 지시문만 적용한 짧은 검증 실행 결과, 기본 모델 `claude-opus-4-8` 은 planner·worker·reporter 산출물과 권한 보유 샌드박스 계획 요청까지 네 역할 모두에서 사용자 노출 출력을 한국어로 유지했고 거부가 없었습니다. `gpt-4o` 도 같은 시나리오에서 한국어를 유지했습니다. 반면 저가·소형 모델(예: `gpt-4o-mini`)은 리포트가 원문(중국어)으로 되돌아갔습니다. 출력 언어 품질이 모델 역량에 직접 좌우되므로, 사람이 리포트를 읽는 환경이라면 역량 있는 모델을 쓰십시오.
- **역할·맥락에 따른 드리프트가 남을 수 있습니다.** 언어 자체보다 역할·출력 형식에서 어긋남이 더 자주 나타납니다. 특히 worker 의 최종 한 문장 요약처럼 짧은 산출물에서는 모델이 영어 사고 과정을 그대로 노출하거나, `report_finding` 의 구조화 필드가 대상 앱·기술 용어를 따라 영어로 기울 수 있습니다. 과거 실행에서는 `gpt-4o` 의 planner 상황 요약이 일부 턴에서 중국어로 돌아간 적도 있습니다. 작업 지시에 "한국어로 작성하라"를 명시하면 충실도가 올라갑니다.
- **추론형(reasoning) 모델에는 `max_tokens` 를 넉넉히 주십시오.** 사고 채널을 따로 쓰는 추론형 모델은 응답 토큰 상한이 작으면 그 예산을 내부 추론에 소진하고 사용자에게 보이는 최종 답변을 비워 둘 수 있습니다. 이때는 언어가 아니라 답변 자체가 사라지므로, 해당 LLM 프로파일의 `max_tokens` 를 충분히 크게 잡으십시오.
> **OpenAI 호환 경로의 토큰 상한 함정.** `gpt-4o` 처럼 OpenAI 계열 모델은 응답 토큰 상한이 16,384 입니다. 그런데 OpenAI 호환 요청에는 기본적으로 더 큰 출력 상한(32,768)이 실려, 그대로 두면 모든 호출이 `400 (max_tokens is too large)` 으로 실패합니다. 이때는 **LLM 설정에서 해당 프로파일의 `max_tokens` 를 16,384 이하로 지정**하십시오. Anthropic 계열(기본 모델 `claude-opus-4-8` 등)은 32,768 을 허용하므로 이 함정에 걸리지 않습니다.
### 리버스 프록시 배포 (HTTPS / 443 만 개방)
프런트엔드와 API/SSE 모두 같은 백엔드 포트(기본 `:8787`)가 제공하고, 실시간 활동 스트림은 기본적으로 **동일 출처(same-origin)** 로 연결합니다. 따라서 `NEXT_PUBLIC_SSE_BASE` 를 따로 설정할 필요 없이, 공개망에는 443 만 열고 8787 은 내부망에 두면 됩니다.
SSE 는 장시간 연결로 이벤트를 계속 밀어 주므로, 리버스 프록시에서 **버퍼링을 반드시 꺼야** 합니다. 끄지 않으면 브라우저가 연결은 되지만 이벤트를 못 받습니다(활동 스트림이 계속 로딩 상태로 보임). Nginx 설정 예시는 [`README.zh.md`](README.zh.md#反向代理部署https--只开放-443)에 있습니다.
---
## 시스템 아키텍처
ARTEX 는 **LLM 멀티 에이전트가 구동하는 자율 침투 시스템**입니다. Go 단일 백엔드(Next.js 프런트엔드 내장)에 PostgreSQL 을 쓰고, 에이전트 기능은 [`norma`](https://github.com/Autumn-27/norma) SDK 가 제공합니다. 핵심은 **이중 그래프 구조**와, 그것을 둘러싼 두 가지 자율성 장치(worker 사이의 과정 단위 정보 교환, planner 의 다중 라운드 공유 todolist)입니다.
### 전체 계층
```mermaid
flowchart TB
subgraph FE["프런트엔드 Next.js (go:embed 단일 바이너리 내장)"]
UI["대시보드 · 작업 · 자산 · 커버리지 그래프 · 트래픽 · 워크스페이스 · 시스템 설정"]
end
subgraph SRV["server (Go net/http)"]
API["REST /api/* JWT 인증 SSE"]
ENG["engine 스케줄링 루프"]
MGR["Manager 작업/엔진/store 생명주기"]
end
subgraph AG["agent (norma SDK)"]
GO["goals 목표 분해 + 범위 추출"]
PL["planner 계획자 (유일한 의도 생성자)"]
WK["worker 실행자 ×N"]
MA["mainagent 사람 개입"]
end
subgraph DB["PostgreSQL"]
AGRAPH["자산 그래프 assets / companies / task_scope"]
EGRAPH["탐색 그래프 exploration_nodes / anchors / activity"]
end
subgraph SUB["지원 서브시스템"]
PROXY["트래픽 기록 프록시 MITM + CA 기록"]
GUARD["guard / intercept 도구 승인 게이트"]
ENR["enrich DNS / HTTP 비동기 보강"]
EXT["MCP · skills · memory · report"]
end
UI -->|HTTP| API
API --> MGR --> ENG
ENG --> PL
ENG --> WK
API --> MA
API --> GO
PL --> DB
WK --> DB
MA --> DB
GO --> DB
WK -->|"Bash / HTTP 전 과정 기록"| PROXY
WK --> GUARD
WK --> ENR
PL -.-> EXT
WK -.-> EXT
MA -.-> EXT
```
- **프런트엔드**: Next.js 정적 빌드를 `go:embed` 로 단일 바이너리에 내장합니다. 작업·자산·탐색 체인·커버리지 그래프를 시각화하고, 사람이 개입하는 대화를 제공합니다.
- **server**: `net/http` 라우팅과 JWT 인증, SSE 를 담당하고, `Manager` 가 작업·엔진·DB store 의 생명주기를 관리합니다.
- **engine**: 작업마다 `plannerLoop` 하나와 worker goroutine N 개를 돌리며, 의도 배정과 타임아웃·일시정지·드레인을 처리합니다.
- **agent**: goals / planner / worker / mainagent 로 나뉘고, `ToolSet` 이 이중 그래프를 LLM 도구로 노출합니다.
- **db**: 이중 그래프를 PostgreSQL(pgx)에 저장하고, `go:embed` 로 들어간 스키마가 매 기동마다 멱등하게 테이블을 만듭니다.
- **지원**: 기록형 MITM 프록시, 승인 게이트, 비동기 보강, MCP·스킬·메모리·리포트.
### 이중 그래프 구조: 탐색 그래프 + 자산 그래프
시스템은 "대상이 무엇인가"와 "어디까지 테스트했는가"를 서로 독립적이면서 앵커로 연결되는 두 그래프로 나눕니다.
- **자산 그래프(Asset Graph, 전역 공유)**: 작업을 가로질러 공유하는 자산 진실 저장소입니다. 노드는 `root_domain / subdomain / ip / service / app / endpoint` 이고 회사에 귀속됩니다. 도메인→서브도메인→서비스→엔드포인트의 부모·자식 관계와 중복 제거 키는 전부 프로그램이 계산하며, 에이전트는 원본 정보만 제출합니다.
- **탐색 그래프(Exploration Graph, 작업마다 독립)**: 한 작업의 "사고와 진행" 과정입니다. 노드는 `goal(목표) / intent(의도) / fact(사실) / finding(취약점) / hint(힌트)` 이고, `spawns / derived_from / yields / proves` 같은 간선으로 혈통 체인을 이룹니다.
- **두 그래프는 앵커로 연결됩니다.** `exploration_anchors(node_id, asset_id)` 가 의도·사실·취약점을 구체적인 자산에 고정합니다. 덕분에 탐색 방향에서 그것이 어떤 자산을 공략했는지, 반대로 어떤 자산이 이번 작업에서 어떤 의도로 테스트되고 어떤 사실을 냈는지를 양방향으로 조회할 수 있습니다.
```mermaid
flowchart LR
subgraph EG["탐색 그래프 (작업마다 독립 · 진행 체인)"]
direction TB
G["goal 목표"]
I1["intent 의도 A"]
F1["fact 사실"]
I2["intent 의도 B"]
FD["finding 취약점"]
G -->|spawns| I1
I1 -->|yields| F1
F1 -->|derived_from| I2
I2 -->|proves| FD
end
subgraph AG["자산 그래프 (전역 공유 · 진실 저장소)"]
direction TB
RD["root_domain"]
SD["subdomain"]
SV["service"]
EP["endpoint"]
RD --> SD --> SV --> EP
end
I1 -. anchor .-> SD
F1 -. anchor .-> SV
I2 -. anchor .-> EP
FD -. anchor .-> EP
```
> 역할 분담: **planner** 는 탐색 그래프의 상황을 읽고 목표를 판정하며, 아직 커버하지 못한 새 방향이 있을 때만 **의도**를 frontier 에 보냅니다. **worker** 는 **의도 하나**를 맡아 실제 도구로 실행하고, 새 자산·사실·취약점을 두 그래프에 써 넣은 뒤 멈춥니다. 자산 그래프는 공유 사실이고, 탐색 그래프는 작업마다의 진행 체인입니다.
### 엔진과 의도 생명주기 (한 번의 탐색 폐곡선)
엔진은 **이벤트 구동** 폐곡선입니다. 그래프가 바뀌면 planner 를 깨우고, planner 가 의도를 보내면 worker 가 그 의도를 맡아 실행한 뒤 결과를 써 넣으며, 그 쓰기가 다시 다음 라운드를 촉발합니다. 이 순환은 목표가 증명될 때(`prove_goal`)까지 이어집니다.
```mermaid
sequenceDiagram
autonumber
participant EV as 그래프 변경 debounce
participant P as planner
participant FR as frontier 의도 큐
participant W as worker
participant PX as 기록 프록시
participant DB as 이중 그래프 + activity
EV-->>P: 깨우기
P->>DB: 상황 읽기(graph_overview 선취 + coverage/scope)
P->>FR: 의도 0..N 개 배정(asset_ids 포함)
Note over P,FR: 대부분의 깨우기는 0 개 배정 — 새 방향이 없으면 종료
W->>FR: claimNext 로 의도 하나 수령
W->>DB: 의도의 asset_ids 원본 자산을 초기 정보로 가져옴
W->>PX: 실제 도구 실행(Kali / Bash / HTTP)
PX-->>W: 응답(전 과정 기록 + CA 검증)
W->>DB: fact / asset / finding + 단계별 activity 기록
DB-->>EV: 그래프 변경
EV-->>P: 다시 깨우기(폐곡선)
```
### worker 사이의 과정 단위 정보 교환
깊은 탐색에서는 값진 관찰(어떤 오류, 어떤 응답 조각, 숨은 파라미터)이 한 worker 의 **실행 과정**에서 나오지만 정식 fact 로는 기록되지 않는 경우가 많습니다. 중복 노동을 피하고 뒤따르는 worker 가 앞선 관찰 위에 설 수 있도록, worker 는 **다른 work 의 과정을 검색하는** 능력을 갖습니다.
- `search_all_worker_traces(q)`: 같은 작업의 다른 work 실행 과정을 키워드로 검색합니다(자기 의도의 단계는 자동 제외). 명중 항목에는 `intent_id` 가 붙습니다.
- `list_worker_traces` / `get_worker_trace(intent_id, step_ids=[…])`: 어떤 work 들이 돌았는지 먼저 보고, 특정 work 의 몇 단계만 전체 내용으로 가져와 세부를 교환합니다.
이렇게 탐색 그래프에 아직 대응하는 fact 가 없어도 뒤따르는 worker 가 남의 과정 속 관찰을 재사용합니다. 정보는 worker 사이를 "실행 과정" 단위로 흐르되, 경계는 그대로입니다(각 worker 는 여전히 자기가 맡은 의도 하나만 수행).
```mermaid
flowchart LR
WA["worker A (의도 #12)"] -->|"단계별 activity"| ACT[("탐색 그래프 · activity 과정 라이브러리")]
WB["worker B (의도 #34)"] -->|"단계별 activity"| ACT
WC["worker C (의도 #56)"] ==>|"① search_all_worker_traces(q)"| ACT
ACT ==>|"② A/B 의 단계 명중 (자기 제외)"| WC
WC ==>|"③ get_worker_trace(intent_id, step_ids)"| ACT
ACT ==>|"④ 전체 과정 내용 반환"| WC
```
### planner 의 다중 라운드 공유 todolist → 안정적인 공격 체인
실제 공격 체인은 앞뒤로 의존하는 여러 단계의 순서(예: 주입점 발견 → 인증 정보 획득 → 측면 이동 → 권한 상승)인 경우가 많아, 이것을 한 번에 병렬로 내려보내면 뒤엉킵니다. 그래서 planner 는 **작업마다 보존되고 깨우기를 가로질러 공유되는 계획 할 일 목록(todolist)** 을 가집니다.
- planner 는 이벤트 구동이라 그래프가 바뀔 때마다 깨어나지만 **매 깨우기가 새 세션**입니다. 공유 todolist 는 직렬 공격 체인을 **한 번만 기록**해 두고, 이후 여러 라운드에 걸쳐 **의존 관계대로 한 단계씩** 의도를 배정하게 합니다(한 라운드에 전체 체인을 앞당겨 펼치지 않음).
- 매 라운드마다 "선행 단계가 끝나고 그 단계가 의존하는 fact 가 이미 존재하는" 다음 단계에만 의도를 배정하고, 진행에 따라 목록을 갱신합니다(fact 로 충족된 단계를 완료 표시).
```mermaid
flowchart TB
subgraph TODO["공유 todolist (작업마다 보존 · 깨우기를 가로질러 상주)"]
direction LR
T1["1 주입점 발견 [완료]"]
T2["2 인증 정보 획득 [진행 중]"]
T3["3 측면 이동 [선행 대기]"]
T4["4 권한 상승 [선행 대기]"]
T1 -. 선행 충족 .-> T2 -.-> T3 -.-> T4
end
R1["1 라운드 깨우기 의도① 배정"] --> T1
R2["2 라운드 (①이 fact 산출) 의도② 배정"] --> T2
R3["3 라운드 (②가 fact 산출) 의도③ 배정"] --> T3
```
이로써 공격 체인은 "이벤트 구동 + 무상태 세션" 환경에서도 안정적으로 진행되고, 중복되지 않고, 순서가 어긋나지 않습니다. 이것이 ARTEX 가 여러 단계의 공격 체인을 자율로 완주하는 핵심입니다.
---
## 방어·탐지 자료
이 저장소는 자율 AI 공격을 **방어하는 쪽**이 그 작동 원리를 이해하고 탐지·차단 역량을 기르도록 돕는 것을 목표로 합니다. 위 아키텍처에서 본 ARTEX 의 동작을 **방어자 관점**으로 뒤집어, 무엇을 관측하고 어디를 조여야 하는지를 한국어로 정리한 가이드를 둡니다.
- **[자율 AI 공격 방어·탐지 가이드 (docs/defense-ko.md)](docs/defense-ko.md)**
- 자율 AI 공격이 기존 스캐너와 무엇이 다른가, 왜 탐지가 어렵고 그래도 어떻게 탐지하는가
- 방어자가 관측할 수 있는 지문(IoC·행동 시그니처): 대상 관점과 포렌식 관점으로 구분
- 공격자가 노리는 진입점과 하드닝(보조 인증·본인확인, API 인가, 자격 증명 스터핑, 세션·비밀 관리)
- WAF·SIEM·인증 로그 탐지 규칙(의사 규칙), 하드닝 체크리스트, 사고 대응 요약
- 국내 공식 침해지표·보안 권고 채널(KISA·금융보안원·개인정보보호위원회)과 국내법상 신고 의무
- **[Defense & Detection Guide (영어판 · docs/defense-en.md)](docs/defense-en.md)**: 해외 팀·협업자와 공유할 수 있는 같은 내용의 영어판입니다.
- **[배포용 탐지 규칙 (detections/README.ko.md)](detections/README.ko.md)**: 위 가이드의 지문 탐지를 바로 쓸 수 있는 규칙으로 제공합니다. 호스트·로그·SIEM 계층은 [Sigma](https://sigmahq.io) 규칙(원자·상관, `sigma convert` 로 Splunk·Elasticsearch 등으로 변환)으로, 네트워크 계층은 enrich 프로브와 norma SDK WebFetch 의 User-Agent 를 겨냥한 [Suricata](https://suricata.io) 규칙으로 나눠 담았습니다.
- **[ATT&CK 커버리지 레이어 (detections/attack/README.ko.md)](detections/attack/README.ko.md)**: 위 규칙이 겨냥하는 MITRE ATT&CK 기법을 [Navigator](https://mitre-attack.github.io/attack-navigator/) 레이어(JSON)로 정리해, 어떤 공격 행위에 어떤 규칙이 걸리는지 한눈에 보도록 했습니다. 기법은 규칙의 `attack.*` 태그에서만 가져왔고 추정으로 넣은 항목은 없습니다.
- **[기계가 읽는 침해지표 목록 (detections/indicators/README.ko.md)](detections/indicators/README.ko.md)**: ARTEX 가 실제로 내보내는 고유 지문을 CSV 한 파일(`artex_indicators.csv`)로 모으고, 같은 지표를 MISP 이벤트(`artex_indicators.misp.json`)로도 함께 제공합니다. SIEM 조회 테이블이나 위협 인텔리전스 플랫폼(MISP·C-TAS·FSI 등 MISP 형식을 받는 곳)에 바로 가져올 수 있는 침해지표(IoC)입니다. 모든 값은 저장소 소스에서 확인한 문자열이고, 각 행에 출처 파일과 탐지 규칙을 함께 적었습니다.
- **[호스트 분류(triage) 스크립트 (detections/triage/README.ko.md)](detections/triage/README.ko.md)**: SIEM 이나 네트워크 센서 없이 의심 호스트 한 대의 셸 앞에 선 대응자를 위한 읽기 전용 스크립트 [`artex_host_triage.py`](detections/triage/artex_host_triage.py) 입니다. 위 규칙과 같은 지문을 점검하고, 여기에 더해 로그나 네트워크로는 관측되지 않아 침해지표 CSV 가 의도적으로 Sigma 규칙 없이 둔 세 가지 호스트·DB 지표(서버 리슨 포트, 기록 프록시 엔드포인트, PostgreSQL 탐색 스키마)까지 호스트에서 직접 확인합니다. 추가 설치 없이 표준 라이브러리만으로 동작하며, 각 발견은 대응하는 침해지표 행과 같은 한계를 지닌 분류 단서일 뿐 그 자체로 단정하는 근거는 아닙니다.
- 위 규칙과 레이어와 지표, 그리고 호스트 분류 스크립트의 자가 테스트는 모두 저장소 테스트([detections/tests/README.ko.md](detections/tests/README.ko.md))로 재실행해 검증합니다. 돌려 볼 수 없는 탐지 규칙은 주장일 뿐이라는 원칙을 따릅니다.
> 이 자료는 계속 보강됩니다. 보완할 탐지 규칙·하드닝 항목은 이슈로 제안해 주시고, 규칙을 직접 보내실 때는 [기여 가이드의 「탐지 규칙·탐지 테스트 기여」 절](CONTRIBUTING.md#탐지-규칙탐지-테스트-기여)에 정리한 계약(관측 가능한 사실에 접지, 한계 명시, 정적 검증 통과, 재현 가능한 테스트 동봉)을 따라 주십시오.
---
## 개발
로컬 개발과 테스트:
```bash
./dev.sh # 백엔드(:8787) + 트래픽 프록시(:8788) + 프런트엔드 next dev(:5173) → http://localhost:5173
```
- 백엔드: `go run ./cmd/artex` (`-tags embedui` 없으면 프런트엔드를 내장하지 않음)
- 프런트엔드: `cd web && npm run dev` (`/api` 를 백엔드로 프록시, 핫 리로드)
- 테스트: `go test ./...`
- Mock 미리 보기(백엔드 없이): `cd web && NEXT_PUBLIC_MOCK=1 npm run dev`
그 밖의 개발 항목(수동 취약점 재검증 등)은 [`README.zh.md`](README.zh.md#开发)의 "开发"(개발) 절을 참고하십시오.
이 한국어판이 상류 ARTEX 에 더한 변경은 [변경 이력(CHANGELOG.md)](CHANGELOG.md)에 정리되어 있습니다.
---
## 라이선스와 면책
### 오픈소스 라이선스
이 프로젝트는 **GNU Affero General Public License v3.0(AGPL-3.0)** 으로 배포됩니다. 전체 조항은 저장소 루트의 [LICENSE](LICENSE) 파일에 있습니다.
누구나 자유롭게 사용·수정·배포할 수 있지만, **파생 저작물도 똑같이 AGPL-3.0 으로 공개해야 합니다.** 특히 이 프로젝트를 수정해 **네트워크를 통해(예: 온라인 서비스로 배포) 사용자에게 제공한다면, 그 사용자에게 대응하는 완전한 소스 코드를 공개해야 합니다.** 이 한국어판 역시 AGPL-3.0 을 그대로 유지합니다.
> ⚠️ **중요:** 오픈소스 라이선스 자체는 소프트웨어의 사용 용도를 제한하지 않습니다. 아래 "사용 제한"과 "면책"은 원저자가 사용자에게 추가로 요구하는 약정이자 엄중한 고지이므로 반드시 지켜 주십시오.
### 사용 제한
- 이 도구는 **소스 코드를 읽고 학습·연구하는 용도**, 그리고 **로컬 격리 환경에서 기술 원리를 검증**하는 용도로 쓰십시오.
- 자신이 소유하거나 **서면으로 명시적 허가를 받은 대상이 아니라면**, 어떤 웹사이트·온라인 서비스·연결된 시스템에도 스캐닝·탐지·익스플로잇·공격을 수행하지 마십시오.
- 불법 침입, 데이터 탈취, 서비스 거부(DoS), 그 밖에 파괴적·범죄적 활동에 사용하는 것을 엄격히 금지합니다.
- 사용자가 속한 국가·지역의 네트워크 보안·데이터 보호·컴퓨터 범죄 관련 법규(대한민국의 경우 정보통신망법·개인정보보호법 등)를 모두 준수해야 합니다.
### 면책
이 프로젝트는 "있는 그대로(AS IS)" 제공되며 명시적·묵시적 어떤 보증도 하지 않습니다. 원저자와 기여자는 이 도구의 사용(사용 방식의 적절성과 무관하게)으로 발생한 어떤 직접·간접 손해, 데이터 손실, 시스템 손상, 법적 분쟁에도 책임지지 않습니다. **이 프로젝트를 내려받거나 설치하거나 사용하는 것은 위 모든 조건을 읽고 이해하고 동의한 것으로 봅니다.**
**모든 법적 책임과 결과는 사용자 본인이 부담합니다.**
---
## 원본 프로젝트
- 원본 저장소: [Autumn-27/ARTEX](https://github.com/Autumn-27/ARTEX)
- 원본 README(중국어): [README.zh.md](README.zh.md)
- 원본 온라인 데모(중국어 UI): [https://artex-demo.vercel.app/](https://artex-demo.vercel.app/)
- 에이전트 SDK: [Autumn-27/norma](https://github.com/Autumn-27/norma)